Network MPLS

参考:MPLS是什么?MPLS是如何工作的? – 华为 (huawei.com)

什么是MPLS – 华为 (huawei.com)

MPLS 定义

多协议标签交换MPLS(Multiprotocol Label Switching)是一种IP(Internet Protocol)骨干网技术。MPLS在无连接的IP网络上引入面向连接的标签交换概念,将第三层路由技术和第二层交换技术相结合,充分发挥了IP路由的灵活性和二层交换的简捷性。

MPLS起源于IPv4(Internet Protocol version 4),其核心技术可扩展到多种网络协议,包括IPv6(Internet Protocol version 6)、IPX(Internet Packet Exchange)和CLNP(Connectionless Network Protocol)等。MPLS中的“Multiprotocol”指的就是支持多种网络协议

由此可见,MPLS并不是一种业务或者应用,它实际上是一种隧道技术。这种技术不仅支持多种高层协议与业务,而且在一定程度上可以保证信息传输的安全性。

MPLS的起源与ATM

MPLS(Multiprotocol Label Switching)。

传统的路由查找是通过最长匹配算法查找路由,在大型的网络中这种通过路由器主要通过软件方式来查找路由表,效率很低,这就导致路由器的IP转发性能低下。

ATM(Asynchronous Transfer Mode)技术应运而生。ATM采用定长标签,并且只需要维护比路由表规模小得多的标签表,能够提供比IP路由方式高得多的转发性能。然而,ATM协议相对复杂,且ATM网络部署成本高,这使得ATM技术很难普及。

ATM技术虽然没有成功,但其中的几点心法口诀却属创新:

  • 摒弃了繁琐的路由查找,改为简单快速的标签交换;
  • 将具有全局意义的路由表改为只有本地意义的标签表。

MPLS将自己定位在第2. 5层的位置,可以承载多协议报文。
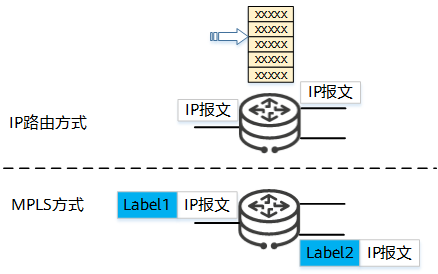
MPLS 心法-基于标签的转发
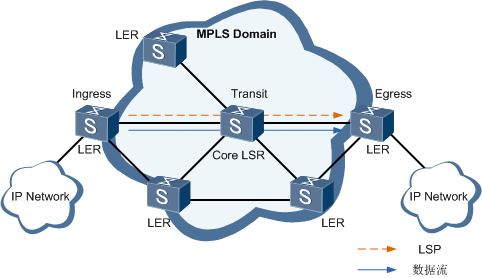
MPLS 通常对经过的数据流打上标签(Label),标签只具有本地意义,数据流根据相同的属性(例如:目的路由、cos、隧道)归类被叫作FEC(转发等价类).由LSR(Label Swithcing Router) 负责对标签报文进行快速的令牌交换操作(标签交换,SWAP)。数据流所走的路径就是标签交换通道LSP(Label Switched Path)。

MPLS标签交换和报文转发的网络设备称为标签交换路由器LSR(Label Switching Router)

LSR、LER的定义:

由LSR构成的网络区域称为MPLS域(MPLS Domain)。位于MPLS域边缘、连接其他网络的LSR称为边缘路由器LER(Label Edge Router),区域内部的LSR称为核心LSR(Core LSR)。(LER 是LSR 的特殊情况,连接用户的网络一侧)

FEC定义:

MPLS将具有相同特征的报文归为一类,称为转发等价类FEC(Forwarding Equivalence Class)。属于相同FEC的报文在转发过程中被LSR以相同方式处理。

FEC可以根据源地址、目的地址、源端口、目的端口、VPN等要素进行划分。例如,在传统的采用最长匹配算法的IP转发中,到同一条路由的所有报文就是一个转发等价类。

MPLS 标签的产生

MPLS 有多种标签发布协议,LDP、RSVP-TE、MP-BGP.

在MPLS中,有一个叫LDP(Label Distribution Protocol)的秘笈,是一个动态的生成标签的协议。
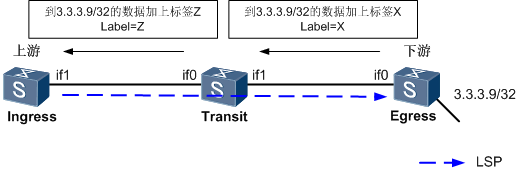
标签由数据流经的LSP上的下游LSR分配,按从下游到上游的方向分发。如上图,Egress告诉Transit说:如果你要转发到3.3.3.9/32的数据给我,你就为报文加上标签X。接着Transit又向Ingress说:如果你要转发到3.3.3.9/32的数据给我,你就为报文加上标签Z。

LSR(Transit)设备上的标签转发信息:

IN interfaceIN labelPrefix/MASKOUT interface (nexthop)OUT label
If0Z3.3.3.9/32if1X

这里的IN和OUT,是相对于标签转发设备而言,不是相对于标签分配设备,总结一个心法口诀就是:

! 入标签是我分给上游设备的,出标签是下游设备分给我的。

!我分配的标签是给上游设备用的,由上游设备添加到报文中。

标签发布协议是MPLS的控制协议(也可称为信令协议),负责FEC的分类、标签的分发以及LSP的建立和维护等一系列操作

RSVP-TE(Resource Reservation Protocol Traffic Engineering)是对RSVP的扩展,用于建立基于约束的LSP。它拥有普通LDP LSP没有的功能,如发布带宽预留请求、带宽约束、链路颜色和显式路径等。

MP-BGP(Multiprotocol Border Gateway Protocol)是在BGP协议基础上扩展的协议。MP-BGP支持为MPLS VPN业务中私网路由和跨域VPN的标签路由分配标签。

MPLS 报文转发过程

标签操作类型包括标签压入(Push)、标签交换(Swap)和标签弹出(Pop),它们是标签转发的基本动作。
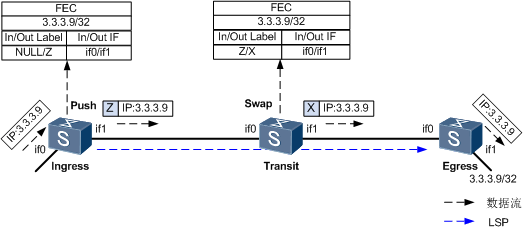
在MPLS标签分配完毕之后,一条转发报文的LSP就建立完成了。LSP(标签交换通道)上的每个设备在收到报文之后根据标签进行转发。还是用上面这个例子,Ingress节点收到目的地址为3.3.3.9的IP报文,压入标签Z并转发。Transit节点收到带标签Z的报文,进行标签交换,替换为标签X并转发报文。Egress节点收到该报文后弹出标签,变为IP报文,而后将其转发给目的地3.3.3.9/32。

PHP 特性:

  • Push:当IP报文进入MPLS域时,MPLS边界设备(LER)在报文二层首部和IP首部之间插入一个新标签;或者MPLS中间设备根据需要,在标签栈顶增加一个新的标签(即标签嵌套封装)。
  • Swap:当报文在MPLS域内转发时,根据标签转发表,用下一跳分配的标签,替换MPLS报文的栈顶标签。
  • Pop:当报文离开MPLS域时,将MPLS报文的标签剥掉。在最后一跳节点,标签已经没有使用价值。这种情况下,可以利用倒数第二跳弹出特性PHP(Penultimate Hop Popping),在倒数第二跳节点处将标签弹出,减少最后一跳的负担。最后一跳节点直接进行IP转发或者下一层标签转发。默认情况下,设备支持PHP特性,支持PHP的Egress节点分配给倒数第二跳节点的标签值为3。
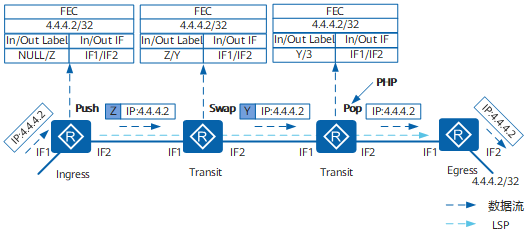
  1. Ingress节点收到目的地址为4.4.4.2的IP报文,压入标签Z并转发。
  2. Transit节点收到该标签报文,进行标签交换,将标签Z换成标签Y。
  3. 倒数第二跳Transit节点收到带标签Y的报文。因为Egress分给它的标签值为3,所以进行PHP操作,弹出标签Y并转发报文。从倒数第二跳转发给Egress的报文以IP报文形式传输。
  4. Egress节点收到该IP报文,将其转发给目的地4.4.4.2/32。

MPLS 的应用场景

好景不长,由于网络发展,路由查找速度已经不是阻碍网络发展的瓶颈。这使得MPLS在提高转发速度方面不再具备明显的优势.

基于MPLS的VPN

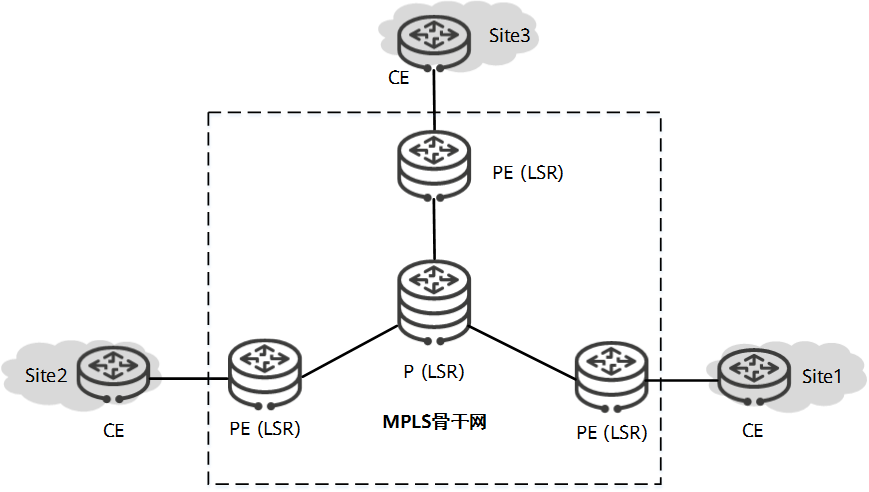
MPLS VPN是指利用MPLS在IP骨干网络上构建VPN的技术。VPN的实质就是在公网上像私有专用网一样传输业务数据,这就需要在公网上建立一条隧道,让数据报文通过隧道直达目的地,从而达到私有专用网络的效果。概括地讲,MPLS VPN就是采用MPLS建立的LSP作为公网隧道来传输私网业务数据的。

MPLS VPN的基本模型主要由以下三种角色构成:

  • CE(Customer Edge):用户网络边缘设备,有接口直接与服务提供商SP(Service Provider)网络相连,用户的VPN站点(Site)通过CE连接到SP网络。CE可以是网络设备,也可以是一台主机。通常情况下,CE“感知”不到VPN的存在,也不需要支持MPLS。
  • PE(Provider Edge):是服务提供商网络的边缘设备,与CE直接相连。在MPLS网络中,PE设备作为LSR,对MPLS和VPN的所有处理都发生在PE上,对PE性能要求较高。
  • P(Provider):服务提供商网络中的骨干设备,不与CE直接相连。在MPLS网络中,P设备作为LSR,只需要处理MPLS,不维护VPN信息。
基于MPLS 的流量工程TE(Traffic Engineering)

流量工程TE(Traffic Engineering)通过动态监控网络的流量和网络单元的负载,实时调整流量管理参数、路由参数和资源约束参数等,使网络运行状态迁移到理想状态,优化网络资源的使用,避免负载不均衡导致的拥塞。

为了在大型骨干网络中部署流量工程,必须采用一种可扩展性好、简单的解决方案。MPLS作为一种叠加模型,可以方便地在物理网络拓扑上建立一个虚拟拓扑,然后将流量映射到这个拓扑上。因此,基于MPLS的流量工程技术应运而生,即MPLS TE。

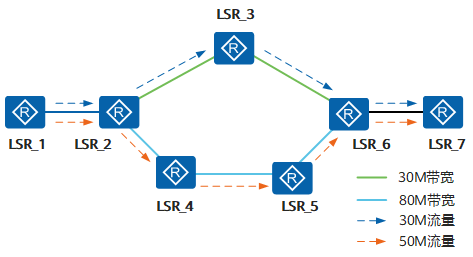
流量工程可以根据带宽等因素合理地分配流量,从而有效地避免链路拥塞。例如,LSR_1到LSR_7存在两种业务,流量分别为30M和50M,流量工程可以把前者分配到带宽为30M的路径上,将后者分配到带宽为80M的路径上。
Network VRF、PE、CE、MCE、P

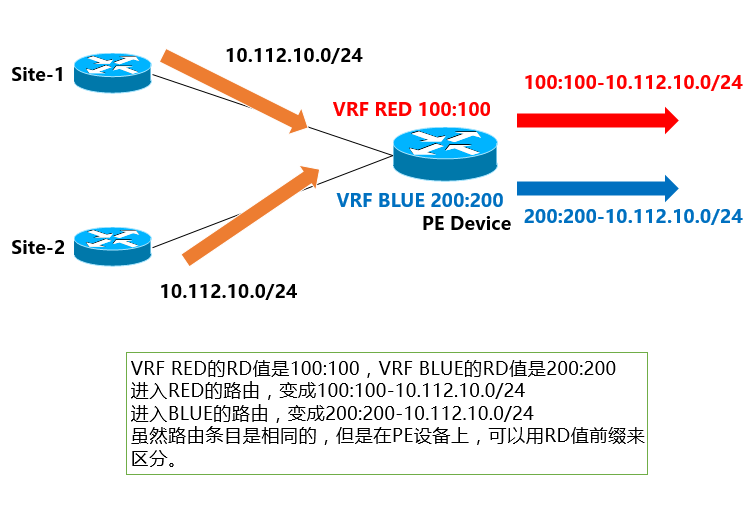
现在问题就来了,为什么进了不同的VRF,就可以使用相同的IP地址或者配相同的网段了呢?我们知道,在交换路由设备上,要在两个三层接口下配置同网段的地址是配置不上的啊。

RD 路由区分符的作用

实际上,VRF里面有一个很重要的组件,叫做RD( Route Distinguisher ),也就是路由区分符号

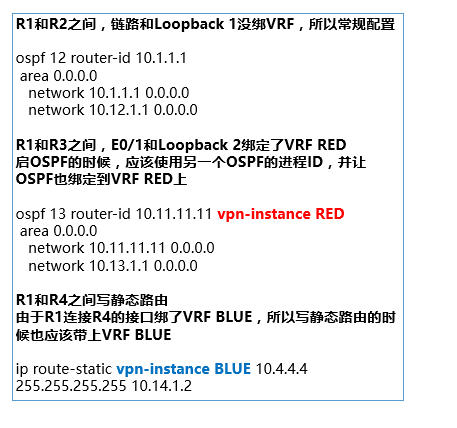
ip vpn-instance BanGong

ipv4-family

route-distinguisher 100:100

VRF 创建后绑定到接口上,接口绑定VRF 会清除之前 配置的IP。

inter g0/0/1

ip binding vpn-instance Bangong

ip add x.x.x.x netmask

ping VRF内的路由的时候,一定要注意带上相应的VRF

例:ping -vpn-instance Instance1 10.3.3.3

Instance1 是名称

当路由从一个不带VRF的设备传递到带VRF的设备,并成功进入到对方的VRF路由表后,就会变成这个样子。看下方的图:

骨干网设备角色

指在骨干网MPLS 中把网络设备分为下列角色

一 P、PE、CE
​ P(Provider)、PE(Provider Edge)、CE(Customer Edge)属于mpls vpn里的概念。在VPN概念中,把整个网络中的路由器如下三类:

第一类,运营商骨干路由器(Provider Route)。属于骨干网上的核心路由器,主要完成快速转发,可以由PE替代。

第二类,运营商边缘路由器(PE)

​ PE充当IP VPN接入路由器,即Provide的边缘设备。服务提供商骨干网的边缘路由器,它相当于标签边缘路由器(LER)。PE路由器连接CE路由器和P路由器,是最重要的网络节点。用户的流量通过PE路由器流入用户网络,或者通过PE路由器流到MPLS骨干网。可以没有P设备,但必须有PE 设备,在PE设备上不仅所有的三层接口要运行MPLS,而且P设备上必须配置VRF(vpn-instance) 。所有PE设备必须与本AS内的PE设备建立 IPV4单播地址簇和vpnV4地址簇的IBGP邻居关系。

第三类,用户边缘路由器(CE)

​ 服务提供商所连接的用户端路由器,CE路由器通过连接一个或多个PE路由器,为用户提供服务接入。CE路由器通常是一台IP路由器,它与连接的PE路由器建立邻接关系(若需要建立BGP邻居,则为EBGP;若需建立OSPF邻居,则为VPN-instance的OSPF邻居)。CE连接骨干网,不能有NAT。如果CE通过路由+NAT 的方式接入Internet。就不构成PE-CE的关系了。

MCE 角色的作用

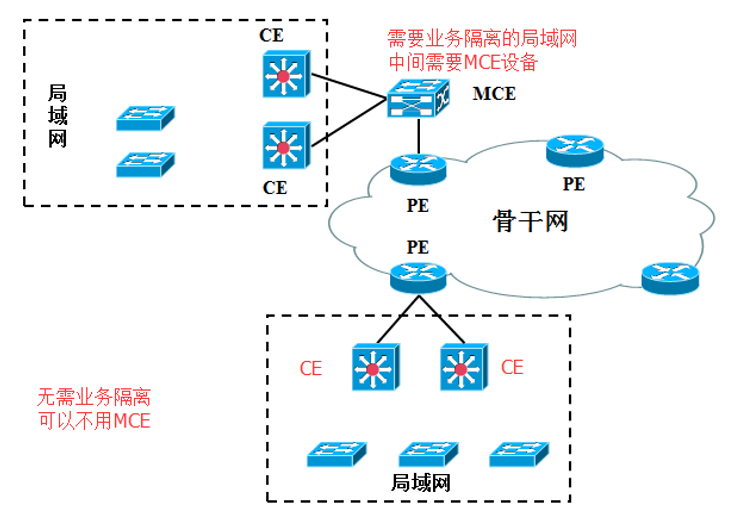
第四类,MCE是CE的特殊情况,用于需要在CE 需要隔离网络业务的情况,MCE和普通CE的区别是MCE有VRF,CE没VRF.


角色/技术MPLS转发MP-BGPBGPVRF
P
PE有(用于路由注入)
MCE有(用于和PE连接)
CE有(只有IPV4,无VRF)

Network BGP 概念

BGP 采用tcp 发现和维护邻居的机制应该是怎样的?

  • 一:TCP面向连接,基于TCP的协议必然有一个先建立连接的过程。要先建立连接,两端的设备就必须先互相知道对方的IP地址,并且路由可达。那么是采用静态配置的方式,还是动态建立连接的方式呢?BGP采用的是静态配置的方式,只要双方指定的地址路由可达,就可以建立连接。这样做有以下好处:
    • 1:可以与对端设备用任何IP地址建立邻居,而不限于某个固定接口的IP。这样,我们就可以采用环回地址而非直连接口地址建立BGP邻居,两台设备之间如果主链路中断了,只要有备份链路存在,就可以把流量切换到备份链路上,保持邻居不断,增加了BGP连接的稳定性。
    • 2:可以跨越多台设备建立邻居。由于是静态配置的方式,不一定只有直连设备才能建立BGP邻居,只要双方指定的地址路由可达(通过IGP或者静态路由),就可以建立邻居,这在AS内部建立IBGP连接时,就不用所有设备之间都建立IBGP连接。IBGP会在本期后面内容中提及。
  • 二:知道对方IP地址后,BGP会通过发送open报文来进行邻居的建立。如果连接不能建立,说明对端设备状态不正常,于是会等待一段时间再进行连接的建立,这个过程一直重复,直到建立连接。
  • 三:连接建立后,就可以进行路由表的同步了,BGP通过发送update报文进行路由表的同步
  • 四:路由表同步完成后,并不是马上拆除这个连接,因为随时有可能会有路由的更新或者删除,建立TCP连接是一个非常耗费资源的过程,所以BGP通过定期发送keepalive报文进行TCP连接的维持,这样就可以不用重新建立连接,立刻就可以进行路由更新
  • 五:如果经过一段时间(一般是3个keepalive报文发送周期 keepalive 消息发送间隔为60秒)还没有收到对方的keepalive报文时,我们就认为对方出现了问题,于是可以拆除该TCP连接,并且把从对方收到的路由全部删除。(一定要在180秒之内收到keepalive 报文,保持对等体peer之间的连接)

IGP 协议要求需要建立邻居关系的两台路由器必须是直连的,然而 BGP 则大不相同。 BGP 的对等体关系并不要求设备必须直连, BGP 采用 TCP 作为传输层协议,两台路由器只要具备 IP 连通性,并且能够顺利地基于 TCP1 79 端口建立连接,就可以建立 BGP 对等体关系,因此 BGP 对等体关系是可以跨设备建立的。

  • 默认情况下,EBGP 邻居之间在发送BGP 报文时,TTL值为1,所以EBGP默认要求邻居之间必须物理直连。当使用环回接口建立EBGP邻居时,由于使用的不是物理直连接口,所以TTL会被多减1次成为0 ,最终BGP报文会被丢弃,从而导致邻居关系建立 失败,可以修改EBGP邻居发送BGP报文的TTL值,使用报文的TTL值大于1 。使用peer 1.1.1.1 ebgp-max-hop 2 命令。在实际场景中使用Loopback 建立 IBGP ,使用直连接口建立EBGP邻居关系

联盟(confederation)和路由反射器(Route Reflector

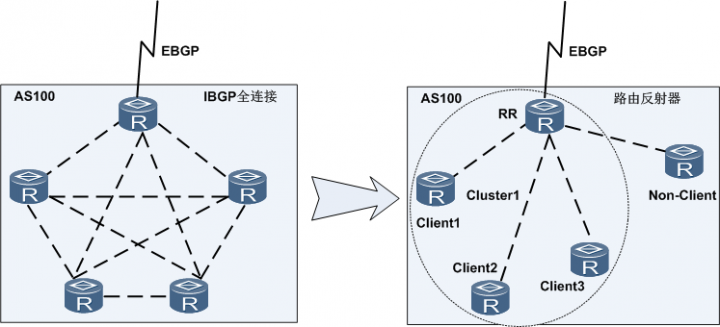
BGP 联盟与路由反射器概念:解决逻辑(物理)全链接IBGP 数量过多的问题

BGP 不同IGP(OSPF、ISIS、RIP都是基于UDP)

每种路由协议的防环机制是什么:

而BGP是距离矢量协议,就是A->B->C-A 之间形成一个环路。

IBGP 路由反射器应用示例

路由反射器的思想:指定其中一台设备可以转发从IBGP对等体收到的路由,则其他设备只需要和该设备建立IBGP连接,就可以保证路由能够传递到所有的设备上。这就是路由反射器的思想。

路由反射器RR的一些概念:

  1. 路由反射器RR(Route Reflector):允许把从IBGP对等体学到的路由反射到其他IBGP对等体的BGP设备,类似OSPF网络中的DR。
  2. 客户机(Client):与RR形成反射邻居关系的IBGP设备。在AS内部客户机只需要与RR直连
  3. 非客户机(Non-Client):既不是RR也不是客户机的IBGP设备。在AS内部所有非客户机与所有RR之间仍然必须建立全连接关系。
  4. 始发者(Originator):在AS内部始发路由的设备。Originator_ID属性用于防止集群内产生路由环路。这点会在后面详细介绍。
  5. 集群(Cluster):路由反射器及其客户机的集合。Cluster_List属性用于防止集群间产生路由环路。这点会在后面详细介绍。

当一个集群里有多个路由反射器时,必须为同一个集群内的所有路由反射器配置相同的集群ID。

如果路由反射器的客户机之间重新建立了IBGP全连接关系,那么客户机之间的路由反射就是没有必要的,而且还占用带宽资源。此时可以配置禁止客户机之间的路由反射,减轻网络负担。

在一个AS内,RR主要有路由传递和流量转发两个作用。当RR连接了很多客户机和非客户机时,同时进行路由传递和流量转发会使CPU资源消耗很大,影响路由传递的效率。如果需要保证路由传递的效率,可以在该RR上禁止BGP将优选的路由下发到IP路由表,使RR主要用来传递路由。

将BGP 路由器配置为RR

bgp 200

router-id x.x.x.x

 peer 10.0.12.1 as-number 200

 peer 10.0.23.1 as-number 200

 #

 ipv4-family unicast

  undo synchronization (关闭同步是指IGP协议的同步)

  reflector cluster-id 1  /配置cluster-id,缺省为设备router id,可选配置

  peer 10.0.12.1 enable

  peer 10.0.12.1 reflect-client   /配置10.0.12.1为客户机

  peer 10.0.23.1 enable

  peer 10.0.23.1 reflect-client

在华为数据通产品上在RR 上对iBGP 增加一条reflect-client 参数就表示iBGP邻居是它的Client了。在Client上按照常规方式和RR建立 iBGP邻居。RR-Client关系只需要在RR上设定不要互相指定不要随意设计多级的RR-Client,就是R2是R3的RR, R3又是R4的RR.

BGP 网络中RR设计规范

iBGP传递路由只能传递一跳,而RR在反射路由的时候也只是多反射一跳,所以在RR-Client这个结构中,iBGP路由也最多反射两跳。

在骨干网络的设计中,只允许设计一级RR,其他的PE设备必须都和RR建立iBGP邻居关系。这就要求iBGP邻居都用Loopback 地址作为更新源,并且由IGP打通Loopback之间的路由。

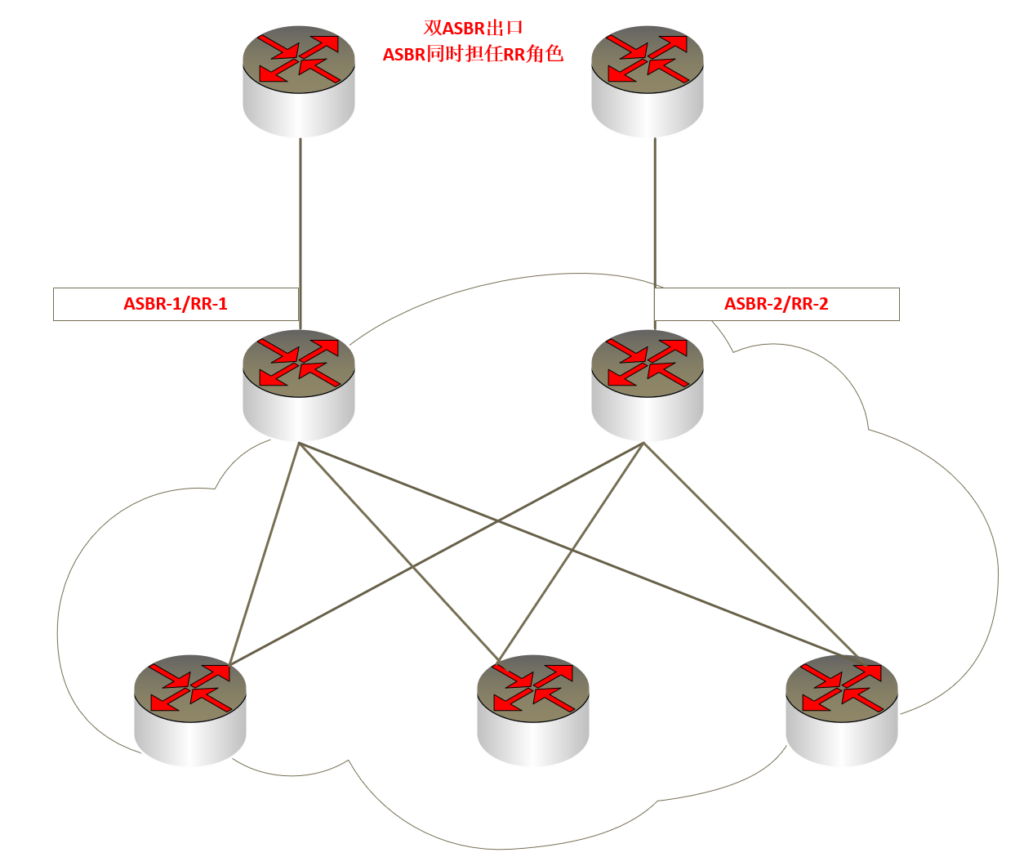
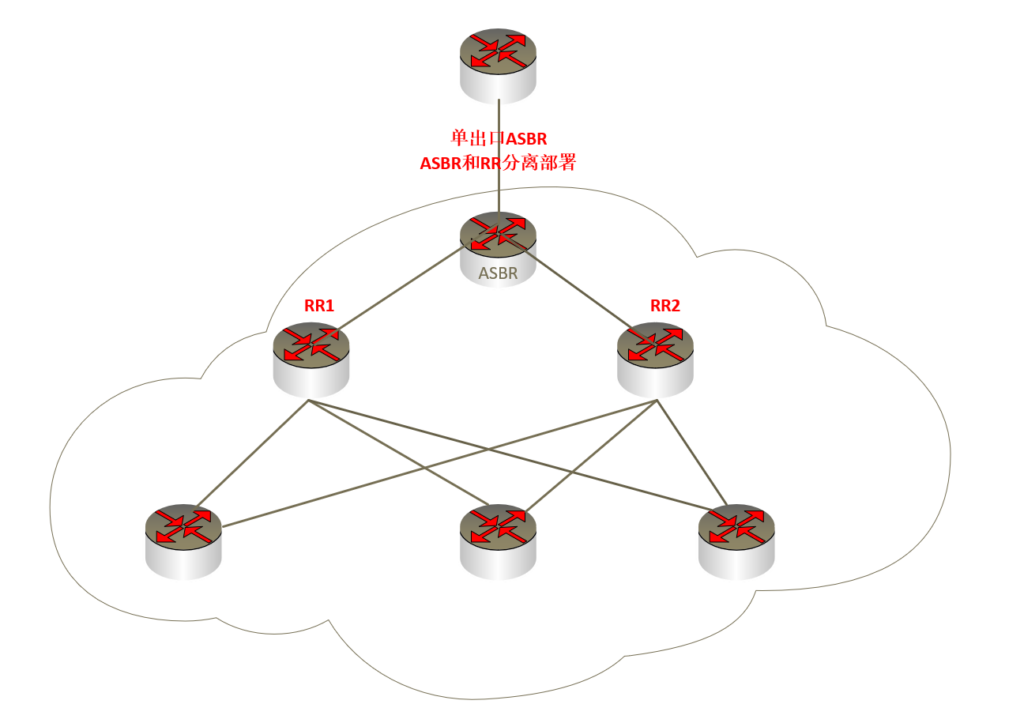
为了保证RR的冗余性,一般在骨干网AS内部都会设置两个RR。再综合考虑网络规模,设备性能等因素,决定ASBR是否同时担任RR的角色。

ASBR 和 RR

RR是负责AS内外路由汇聚的,偶尔也能担负路由选路和路由过滤的功能,且RR也担负着和AS内所有BGP路由器建立iBGP邻居的任务,所以它们在网络中的位置非常重要。

ASBR 和 RR 的几种部署模式:

在2个ASBR同时担任RR 角色时,2个RR 必须建立iBGP邻居关系且互反射,其他BGP 设备也和2个RR 建立iBGP邻居关系,优点是方便配置选路,缺点是ASBR压力巨大只有2个ASBR的情况下,可以选择这种结构。

在只有一个ASBR的情况下,或者2个ASBR堆叠成一台设备时,可以考虑让RR和ASBR角色分离。但不管是什么情况,其他的BGP设备一定要和RR建立邻居关系,RR 之间也要建立邻居关系。这种拓扑下ASBR和RR 分离,设备压力较轻。缺点是BGP选路和设置相对麻烦一些。

BGP 对等体组

在大型BGP网路中,对等体的数目众多,配置和维护极为不便。对于存在相同配置的BGP对等体,可以将它们加入一个BGP对等体组进行批量配置,简化管理的难度,并提高路由发布效率。

  • 对单个对等体和对等体组同时配置了某个功能时,对单个对等体的配置优先生效。
  • 当使用Loopback接口或子接口的IP地址建立BGP连接时,建议对等体两端同时配置步骤6,以保证两端连接的正确性。如果仅有一端配置该命令,可能导致BGP连接建立失败。
  • 当使用Loopback接口建立EBGP连接时,必须配置步骤7(其中hop-count≥2),否则EBGP连接将无法建立。

操作步骤

  1. 执行命令system-view,进入系统视图。
  2. 执行命令bgp { as-number-plain | as-number-dot },进入BGP视图。
  3. 执行命令group group-name [ external | internal ],创建对等体组
  4. 执行命令peergroup-nameas-number { as-number-plain | as-number-dot },配置EBGP对等体组的AS号。
  5. 执行命令peer { ipv4-address | ipv6-address } groupgroup-name,向对等体组中加入对等体。
  6. (可选)执行命令peergroup-nameconnect-interfaceinterface-typeinterface-number [ ipv4-source-address ]或者peergroup-nameconnect-interfaceinterface-typeinterface-number [ ipv6-source-address ] ,指定BGP对等体之间建立TCP连接会话的源接口和源地址。缺省情况下,BGP使用报文的出接口作为BGP报文的源接口。
  7. (可选)执行命令peer group-name ebgp-max-hop [ hop-count ],指定建立EBGP连接允许的最大跳数。缺省情况下,只能在物理直连链路上建立EBGP连接,EBGP连接允许的最大跳数为1。
  8. (可选)执行命令peer group-name description description-text,配置对等体组的描述信息。
  9. 可选)请根据实际网络选择以下命令。
    • 执行命令ipv4-family multicast,进入BGP-IPv4组播地址族视图。
    • 执行命令ipv6-family [ unicast ],进入BGP-IPv6单播地址族视图。
  10. 执行命令peer group-name enable,为原有的BGP对等体组使能MP-BGP功能,成为MP-BGP对等体组。

如果在IPv4单播网络中配置BGP对等体组,不需要执行步骤9和步骤10。如果在IPv4组播和IPv6单播网络中配置BGP对等体组,需要执行步骤9和步骤10。

IBGP和EBGP 防环机制

EBGP的防环机制是添加AS-PATH 属性,IBGP 是使用距离矢量协议的“水平分割”机制防止环路。

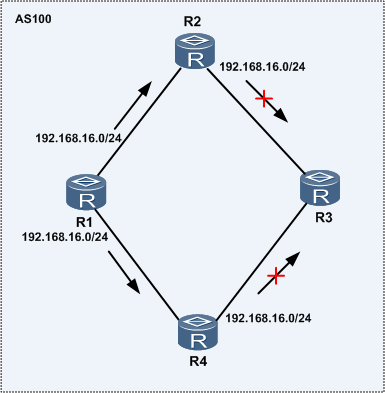
IBGP 防环机制是水平分割:从IBGP对等体接收到的路由不会通告给其他的IBGP邻居。路由只能传递一跳。

即:R2,R4接受到R1的192.168.16.0/24 的路由不会再通告给R3。

R3想学习到192.168.16.0/24的路由必须和R1连接。所以必须在4台路由器之间建立IBGP的全连接的关系,

由于IBGP 内部路由只能传递一跳,所以要想IBGP 邻居获得对端AS 传递过来的路由就需要所有设备和ASBR 建立邻居关系。Full Mesh iBGP

BGP的属性:我们把添加在BGP路由中,为了解决某些问题的数据称为属性。如上文解决EBGP环路问题所引入的数值(AS号),就是我们目前第一次引入的属性的概念,我们称之为AS_PATH属性。在BGP中,属性是一个非常重要的概念,因为BGP相较IGP非常大的一个优势就是可以在路由中携带丰富的属性,这些属性可以帮助我们对路由进行控制。BGP里规定, AS_PATH属性较短的路由,将会被优选。可以手动修改AS_PATH属性。

路径属性

BGP神功之精髓,在于“属性”二字,此出入方向流量的路径控制,也落在这“属性”二字上了。”

LOCAL_PRAF属性

(以下简称LP本地优先级)和(MULTI_EXIT_DISC 出口鉴别)器属性(以下简称MED)是BGP协议在控制AS出口流量路径时经常用到的两个属性。

MED

当一个运行BGP的设备通过不同的EBGP对等体得到目的地址相同但下一跳不同的多条路由时,在其它条件相同的情况下,将优先选择MED值较小者作为最佳路由。

LP属性被用于在去往同一目的地的多条路由中设置路由优先级,从名字就可以看出,LP属性只是应用于本地对等体之间,即只能在IBGP对等体之间传递,不会应用于EBGP对等体之间。LP属性常用于AS出口出方向流量的路径控制,LP属性值越大,路由越优。

通常情况下,MED属性的作用是在去往邻居AS存在多条链路时,允许AS为入站流量传达其优先级。(一般来说,比较不同AS的MED属性没有太大意义,特殊场景除外。)从MED属性的作用可以看出,MED属性只是作用于EBGP对等体,而IBGP对等体互相通告路由时,会忽略MED属性。MED属性常用于AS出口入方向流量的路径控制,MED属性值越小,路由越优

MED只会影响相邻两个AS,收到MED属性的AS不会把此属性再继续传递给别的AS。

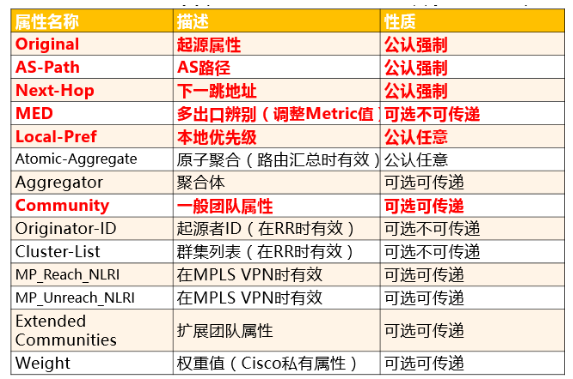
BGP的路径属性列表及分类(标红加粗字体的为常用属性,需要重点了解):

成为BGP的路由有两种方式,一种用network命令发布到BGP路由表中,一种是从IGP路由表中重分发进BGP。使用network命令发布到BGP路由表的,起源属性为“i”;重分发进BGP的路由,起源属性为“?”,读作:imcomplete。

AS_Path:中包含了BGP路由器到达目的地所经过的所有AS号码的集合,如果这条路由是从iBGP传来,则AS-Path属性不显示。而BGP在针对AS-Path执行路径选择的时候,总会选择“AS-Path最短”,也就是包含AS号码最少的路径。这样的话,可能造成BGP选出的“最优路径”实际上是最差的路径

Next-Top 属性:就是下一跳地址属性。但是,BGP的下一跳地址和IGP的下一跳地址是有一定的区别的。IGP也就是我们说的静态路由、OSPF、EIGRP这些路由,它的下一跳地址默认是:“直连设备的互联接口地址”

而BGP的Next-Hop属性却有一定的区别,它是这么定义的:

1、如果是本地始发的路由,则Next-Hop为0.0.0.0,一定会被优选;
2、从邻居学习来的路由,Next-Hop属性为邻居的更新源地址。

如果一条路由从iBGP邻居学习而来,而iBGP邻居的更新源地址通常是Loopback接口地址,则iBGP学习到的路由的Next-Hop属性也将是Loopback接口地址

Next-Hop 地址对当前设备不可达,则这条路由无效。

一个很重要的知识点,就是iBGP和eBGP针对Next-Hop属性的处理。

  • 1、eBGP在传递路由给邻居时,默认会修改路由的Next-Hop属性为自身的更新源地址;
    2、iBGP在传递路由给邻居时,不会修改Next-Hop属性。

使用next-hop-local 修改下一跳地址。

当Next-Hop 下一跳在IBGP 中传递时不修改Next-hop属性会导致,同一AS内除建立EBGP 邻接关系之外的路由器无法到达Next-hop 地址。所以在AS内向IBGP邻居添加Next-hop-local 的原因了,强制IBGP在传递Next-hop下一跳时修改自身的源地址。执行命令peer { ipv4-address | group-name | ipv6-address } next-hop-local,配置BGP设备向IBGP对等体(组)发布路由时,把下一跳地址设为自身的IP地址。缺省情况下,BGP设备向IBGP对等体发布路由时,不修改下一跳地址

BGP 的更新源 IP 地址也即设备发送 BGP 协议报文时所使用的源 地址,该地
址可以是设备直连接口的 IP 地址,也可以是设备的 Loopback 接口 IP 地址。

AS-PATH 属性

AS-PATH 属性是不能重复的,但AS号码是可以重复的,这也就表示可以往AS-Path属性中添加多个重复的AS号码,以加长非优选方向的AS-Path长度。

BGP 路由属性的比较顺序

BGP路由属性的比较顺序为Preferred Value属性,Local Preference属性,路由生成方式,AS_Path属性,Origin属性,MED属性,BGP对等体类型等。

BGP 更新源接口的使用

在iBGP 内部一般使用环回接口作为更新源,在EBGP之间一般使用物理接口作为更新源。

BGP 路由通告

  • BGP 路由在对等体之间交 时, 要存在以下几个原则:
  • 当一台路由器发现了多条可到达同一个目的网段的 BGP 路由时,该路由器会通过一个路由选择进程在这些路由中选择一条最优 CBest) 的路由。通常情况下,路由器只将最优的路由加载到路由表中使用(激活了负载分担功能的情况除外),而且只会将最优的路由通告给 BGP 对等体。
  • 当一台路由器从自己的 EBGP 体学习到 BGP 路由时,缺省时它会将这些路由通告给所有 IBGP 对等体及所有 EBGP 对等体。
  • 当一台路由器从自己的 IBGP 对等体学习到 BGP 路由时,它不会将这些路由通告给其他 IBGP 对等体一-IBGP 的水平分割规则使然。
  • 当一台路由器从自己的 IBGP 体学习到 BGP 路由时,如果 BGP 同步被激活,则路由器只有从 IGP 协议也学习到相应的路由时,才会将这些 BGP 路由通告给 EBGP体:如果 BGP 同步被关闭,则即使没有从 IGP 协议学习到相应的路由,它也会将这些 BG 路由通告给 EBGP 对等体。

BGP 路由发布

使用network 发布路由的时候要确保这个路由在路由表中存在,且命令所指定的网段及掩码长度必须与路由表中对应的路由完全一致。

Network SVF

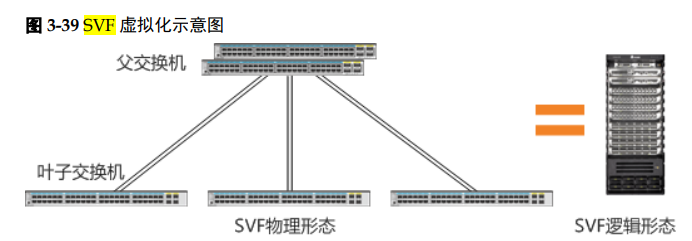
设备纵向虚拟化 Super Virtual Fabric

SVF中有两类交换机角色:
Spine,也称父交换机,是整个SVF系统的核心,负责整个系统的控制和管理。
Leaf,也称叶子交换机,是纵向扩展设备,可以理解为Spine的远程接口板,由Spine进行统一管理。

Network Vxlan 网络部署方式

CE系列交换机支持通过单机方式和控制器方式来部署VXLAN网络。这两种方式中VXLAN网络的子网互通以及VXLAN网络的可靠性的实现均与前面一致,不同点在于VXLAN的配置下发方式不同:

单机方式是通过CLI手动在设备上进行配置,

控制器方式是通过控制器向设备下发配置或流表,设备仅作为转发器