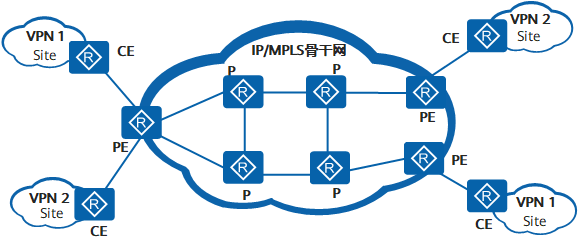
Network MPLS VPN 基础概述

路由的交互与数据的交互

1、CE 需要将自己的路由交付给MPLSVpn服务提供商,由服务提供商负责站点间的路由传递。当然交互路由的目的是实现站点间数据的交互。

CE与PE 的路由交换方式

2、客户端CE与PE路由的交互可以是IGP(ospf、is-is) 或者静态路由、BGP;无论是通过哪种方式,必须让PE设备知晓其直连客户的客户路由。PE与CE的路由交换方式是灵活的,当然,同一个客户的不同站点也可选用不同的”PE-CE 间的路由交互方式”,例如客户 A站点1的CE 设备采用 OSPF 与直连的 PE备交互路由,而客户 A站点2的 CE 设备则采用 BGP 与主连的 PE 设备交互路由。

客户端地址空间重叠

3、问题 :不同客户使用相同的路由子网,PE 怎样进行区分并隔离?即不同客户地址空间重叠;例如,VPN1和VPN2都使用10.110.10.0/24网段地址,这就发生了地址空间的重叠(address spaces overlapping)。在华为路由器上,VRF也被称为VPN实例,这样2个VRF 就是两台独立的虚拟设备,它们拥有独立的路由表、FIB表、动态路由协议进程以及接口等等。因此即使分别从两个不同的客户那里学习到目的网络地址及网络掩码相同的路由也不用担心出现冲突。

客户路由传递的协议

即如何将客户路由从一个站点传递到客户的另一个站点、也就是从一台PE设备传递到另一台PE的设备。在典型的 MPLSVPN 架构中, BGP 是在 MPLS VPN 骨干网络中用于实现客户路由传递的不二选择。 BGP 可承载大批量的路由前缀,被广泛应用于各种大型的网络。

RD 路由区分码、VPNv4路由

当不同的客户端使用了相同的IP地址空间、

时如何保证路由不发生冲突? MPLS VPN 引入了 RD (Route Distinguisher ,路由区分码)用于解决该问题。要解决路由冲突的问题,就必须对 IPv4 路由前缀做扩展。 MPLS VPN 采用 RD IPv4 路由前缀进行扩展,简单地说,就是在 32bit IPv4 路由前缀的基础之上增加一个 64bit RD从而形成 96bit VPN-IPv4 路由前缀(我们也将该路由前缀简称为 VPNv4 路由前缀)。

BGP 与MP-BGP

传统的 BGP 无法运载 VPNv4 路由,因此 MP-BGP (Multi-Protocol BGP ,多协议
BGP) 便被派上了用场 MP-BGP 也被称为基于 BGPv4 的多协议扩展,传统的 BGP只
能运载 IPv4 路由前缀,而 MP-BGP 则可以支持包括 VPN-IPv4 、IPv6 等在内的多种路由
前缀。于是,此时在 PE1及 PE2 之间所建立的 BGP 会话便不再是传统的 BGP 会话,而
是激活了 VPNv4 路由运载能力的 BGP 会话。基于该 BGP 会话所传递的 BGP 路由前缀
不是 IPv4 单播路由前缀,而是 VPNv4 路由前缀。

RT 路由目标

PE 之间收到路由后,如何决定将哪些路由注入本地的哪一个VRF呢?

MPLS VPN 使用 一种特殊的数值来控制客户路由的发布及接收,它就是 RT RouteT: get ,路由目标), RT 也被称为 VPNTarget 一个 RT 的长度为 32bit,一条 VPNv4 路由可以包含一个或多个 RT 。 RT 与VPNv4 路由一起被传递给远端 PE ,它承载在 BGP 扩展 Community 属性中。

MPLS VPN 路由和数据层面

需要考虑MPLS VPN 骨干网络中P设备并不维护客户的路由,MPLSVPN 骨干网络需要考虑如何将报文顺利地从一台 PE 设备转发到另一台PE 设备,而且需在沿途的 P设备并不维护关于目的 IP 地址的路由的情况下实现这个需求。利用 MPLS 技术,采用标签来转发这些报文是一个绝佳的解决方案

MPLS VPN 两层标签

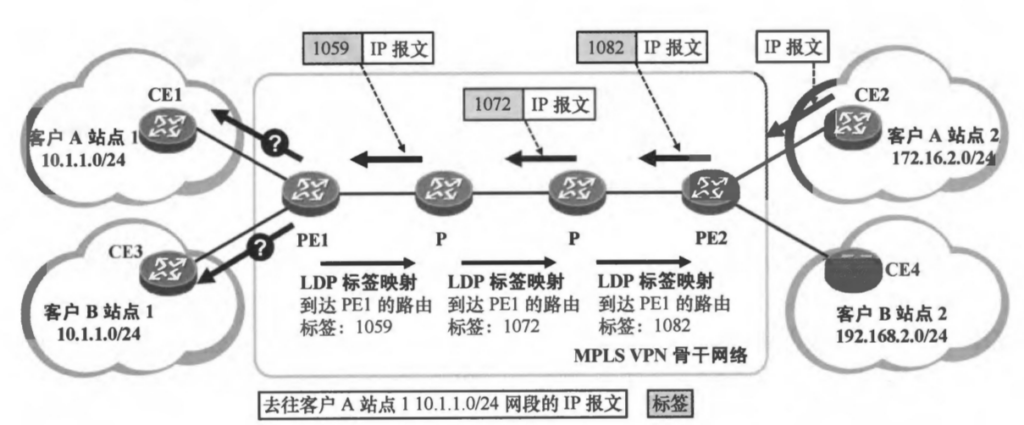
PEl 收到了这个标签报文,接下来它的操作自然是将报文的标签头部弹出,然后将报文路由到目的地。这里还有一个问题: PEl 该把报文转发给 CEl 还是 CE3?无法判断该报文究竟是发往哪一个客户的(报文归属哪一个 VRF)。

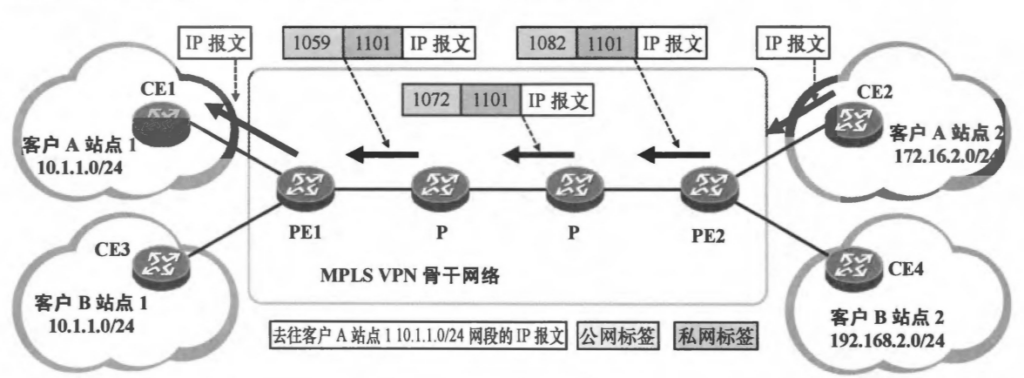
在典型的 MPLSVPN 架构中,报文在 MPLSVPN 网络内转发时采用两层标签。

PE2 转发到达客户 站点 10. 1.1. 0/24 段的报文时,将报文压入两层标签,其中外层标签 (或者说顶层标签)被称为公网标签,公网标签由 LDP 分发,用于将报文转发到 PEl 。

内层标签(或者说底层标签〉被称为私网标签,私网标签则由MP-BGP 分发,用于将报文在 PEl 上对应到具体的 VRF ,或者某一个直连的 CE 设备。为了实现私网标签的分发, PE1通过 MP-BGP VPNv4 路由通告给 PE2 时,除了携带该路由的 RT,还会将其为该路由所分配的私网标签一并携带

PE2 将带有两层标签的报文转发到 MPLSVPN 骨干网络后,网络中的 P设备根据报文的公网标签(外层标签)将其转发到 PE 1.在报文的转发过程中,公网标签被逐跳修改,但是私网标签则不会发生改变。 PEl 收到报文后,先将公网标签弹出,然后根据内层的私网标签将该报文对应到本地的 VRF (由于该私网标签由 PEl 所分配,因此它知道这个标签值所对应的 VRF) ,最后将私网标签弹出,把里面所封装的 IP 报文转发给 CEl.

MPLS 与 LDP

概括的讲MPLS 负责标签的push、pop、swap等操作,MPLS需要为报文事先分配好标签,建立一条LSP,才能进行报文转发。LSP分为静态LSP和动态LSP两种。LDP可以是静态手工分发也可以由动态协议。标签发布协议是MPLS的控制协议(也可称为信令协议),负责FEC的分类、标签的分发以及LSP的建立和维护等一系列操作。

mpls 的体系结构

它由控制平面(Control Plane)和转发平面(Forwarding Plane)组成。
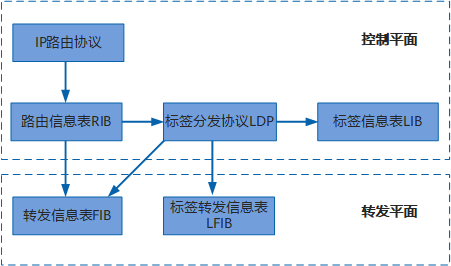
  • 控制平面:负责产生和维护路由信息以及标签信息。
    • 路由信息表RIB(Routing Information Base):由IP路由协议(IP Routing Protocol)生成,用于选择路由。
    • 标签分发协议LDP(Label Distribution Protocol):负责标签的分配、标签转发信息表的建立、标签交换路径的建立、拆除等工作。
    • 标签信息表LIB(Label Information Base):由标签分发协议生成,用于管理标签信息。
  • 转发平面:即数据平面(Data Plane),负责普通IP报文的转发以及带MPLS标签报文的转发。
    • 转发信息表FIB(Forwarding Information Base):从RIB提取必要的路由信息生成,负责普通IP报文的转发。
    • 标签转发信息表LFIB(Label Forwarding Information Base):简称标签转发表,由标签分发协议在LSR上建立LFIB,负责带MPLS标签报文的转发。

MPLS VPN网络实现概述

  • 在PE 设备上,使用 VRF 来区分不同的客户、维护不同客户的路由。
  • 在PE 设备上,使用基于 VRF 的路由协议 (PE-CE 间的路由协议)与其直连的CE 设备交互客户路由。
  • MPLSVPN 骨干网络内的设备上(PE 设备及P 设备),需要运行一个 IGP 协议,通过该协议实现骨干网内的路由互通。
  • PE 设备之间,根据需要建立 MP-BGP 会话, PE 设备将自己从 CE 设备学习到的路由引入 MP-BG 形成 VPNv4 路由并通告给远端 PE 设备,并且将其从远端 PE 设备所学习到VPNv4 路由注入本地相应的 VRF 中,从而通过 PE-CE 间的路由协议将客户路由通告给本地直连的 CE 设备。
  • 为了让客户的数据能够穿越 MPLS VPN 骨干网络需要骨干网络的 PE 设备及设备都激活MPLS 及标签分发协议(通常是 LDP)
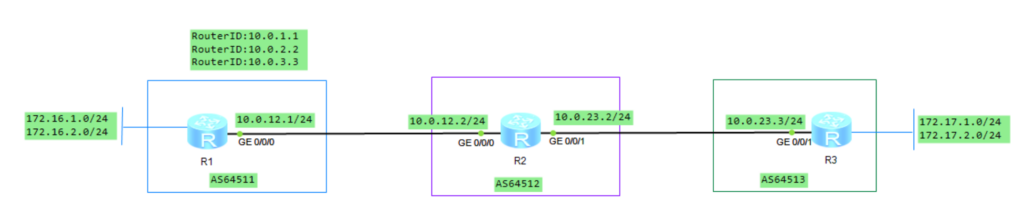
Network BGP汇总(路由聚合)实验

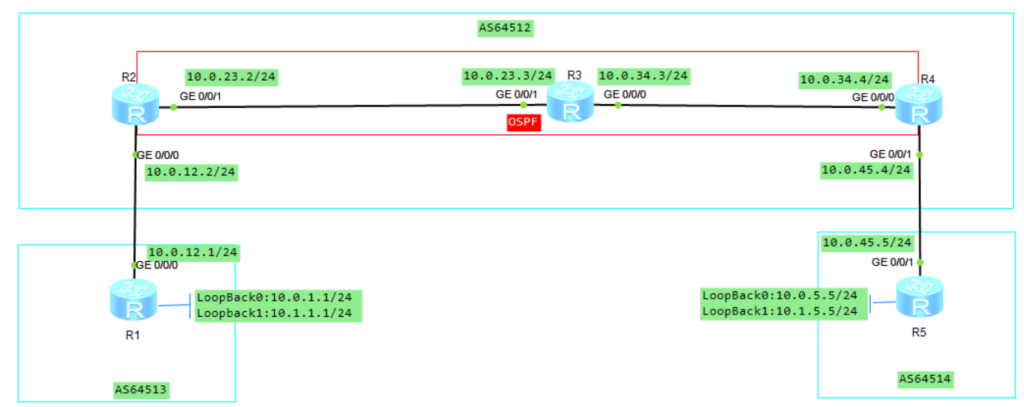
实验拓扑

实验目的

1、在R1上使用import 发布172.16.1.0/24 、 172.16.2.0/24 路由并自动汇总,在R3上使用import-route 命令 发布172.17.1.0/24 、172.17.2.0/24 路由;在R2上执行手动汇总,分辨如果不手动汇总情况下观察各BGP 路由表的as-path 属性。

3、学习BGP 自动汇总,手动汇总,手动汇总关键字as-set的作用首先BGP 自动汇总功能仅对import-route 引入的BGP路由有效,其次 BGP 产生的汇总路由只能是主类网络路由。

4、EBGP 对等体的建立和IBGP 对等体的建立使用的接口一般规则。

5、认识BGP 路由汇总的必要性、路由汇总对AS-PATH的影响,汇总子命令as-set的作用。

6、自动聚合对IP地址规划要求苛刻的,在BGP网络环境中,IP地址规划难以做到规整有序,在实际的项目中,很少启用BGP 自动路由聚合功能。

思考

Aggregate(手动聚合) 和Summary automatic 产生的汇总路由在携带路径属性上有什么不同?

手动聚合的2种方式:

第一种方法是通过配置静态路由使用Network 命令进行通告,在ASBR上写指向Null0接口的大段静态路由,让ASBR的IGP表里有汇总后的大段路由,然后再在BGP地址族里用network发布。

第二种方法是通过Aggregate 命令进行聚合。

使用第一种方法时,无法对通告的静态路由加以控制,并且明细路由仍然会被通告出去。如要抑制明细路由则需要使用Route-Policy 来对明细路由进行过滤,实现起来配置命令较多。使用第二种方法时,缺省情况下明细路由和聚合路由都会被发出去,但是可以通过关键字对全部或部分的明细路由进行控制。

配置步骤

1、配置接口和IP 测试连通性。

2、部署EBGP 使用直连接口作为源接口建立对等体。

3、使用import-route 命令发布路由,使用IP前缀匹配要汇总的路由。

4、验证BGP路由表观察汇总后是否继承了AS-PATH 属性。

一、接口配置

R1为例

dis current-configuration interface
[V200R003C00]
#
interface GigabitEthernet0/0/0
ip address 10.0.12.1 255.255.255.0
#
interface LoopBack0
ip address 10.0.1.1 255.255.255.255
#
interface LoopBack1
ip address 172.16.1.1 255.255.255.0
#
interface LoopBack2
ip address 172.16.2.1 255.255.255.0
#
return

二、BGP 配置

R1 配置

定义要引入的路由

创建IP地址前缀列表,匹配loopback1、LoopBack2接口路由发布到BGP中,并进行自动汇总。

dis current-configuration | include ip ip-prefix
ip ip-prefix 1 index 10 permit 172.16.0.0 16 greater-equal 24 less-equal 24

以上通过配置过滤器“地址前缀列表”(地址前缀列表是过滤器的一种)来匹配过滤路由

创建路由策略 hcip 并创建节点10 在其中调用IP前缀列表1

dis current-configuration configuration route-policy
[V200R003C00]
#
route-policy hcip permit node 10
if-match ip-prefix 1

dis current-configuration configuration bgp

bgp 64511
router-id 10.0.1.1
peer 10.0.12.2 as-number 64512
#
ipv4-family unicast
undo synchronization
summary automatic //开启自动汇总
import-route direct route-policy hcip //import-route 引入直连路由匹配相应的路由策略
peer 10.0.12.2 enable

//自动汇总只对通过import-route 命令引入的路由生效

R2配置

dis current-configuration configuration bgp
[V200R003C00]
#
bgp 64512
router-id 10.0.2.2
peer 10.0.12.1 as-number 64511
peer 10.0.23.3 as-number 64513
#
ipv4-family unicast
undo synchronization
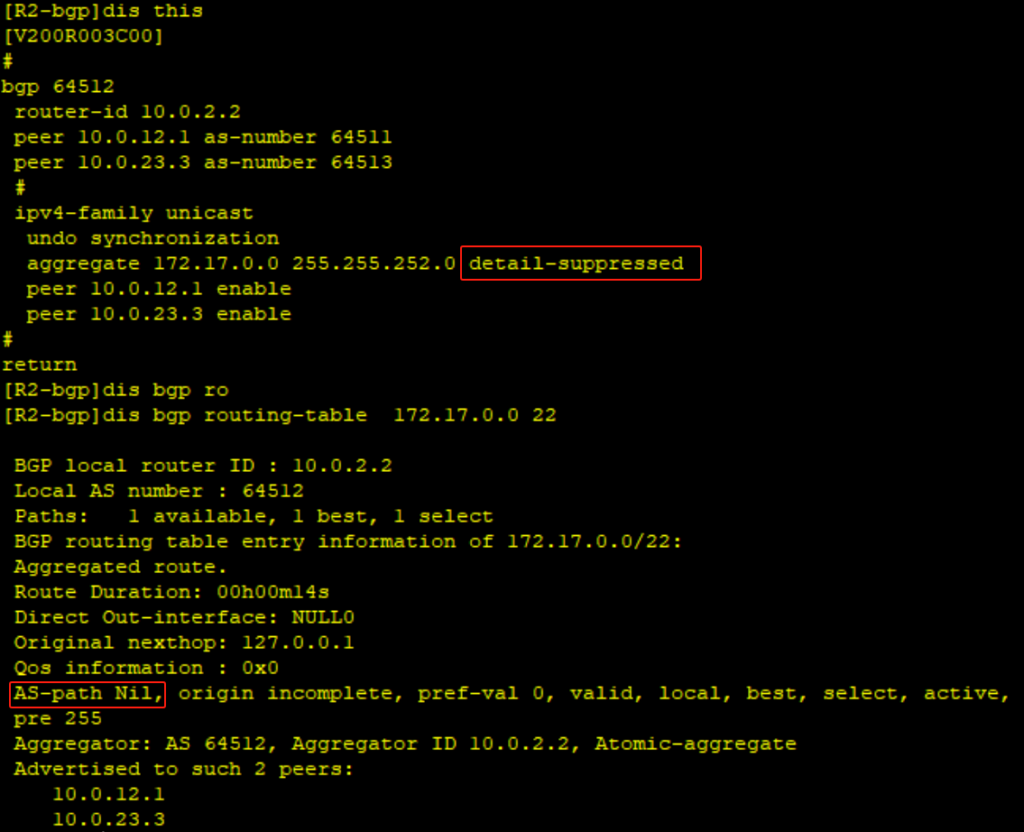
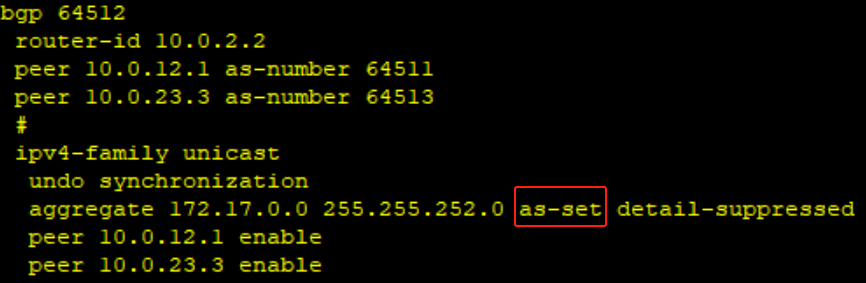
aggregate 172.17.0.0 255.255.252.0 as-set detail-suppressed //注意这里是对R3发布的172.17.1.0 、172.17.2.0 汇总成 172.17.0.0/22 并抑制明细路由的对外通告,如果不加as-set那么R2学习的BGP路由表中as-path 会为空。
peer 10.0.12.1 enable
peer 10.0.23.3 enable
#
return

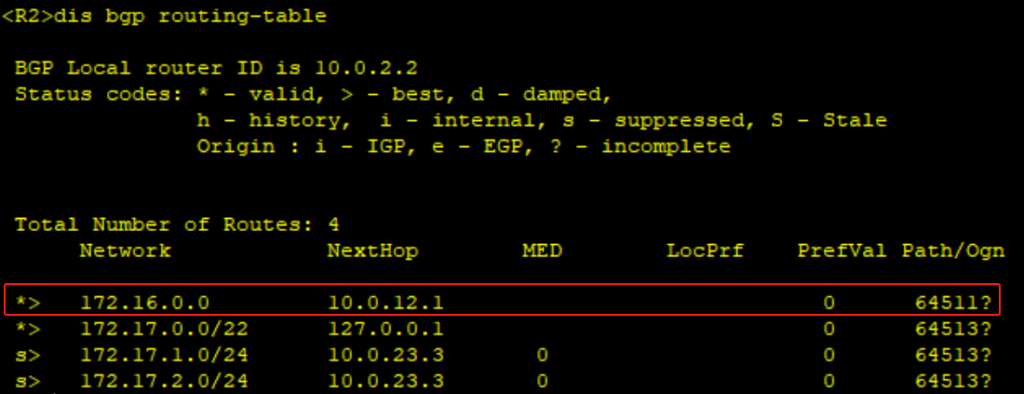
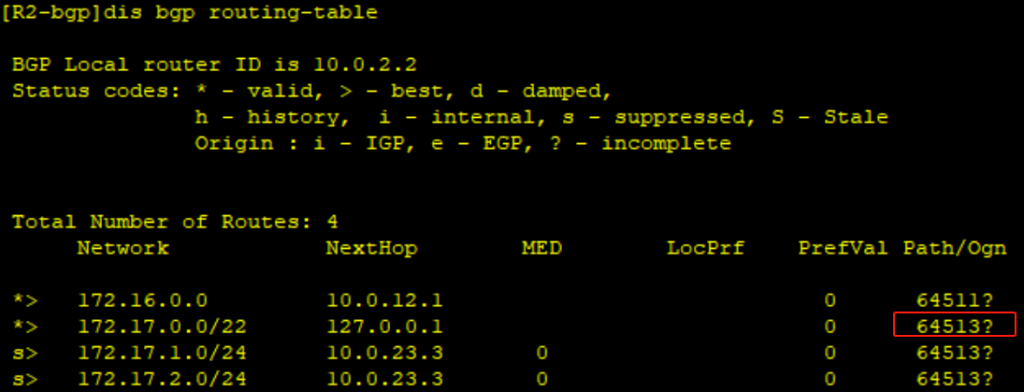
查看R2的bgp 路由表

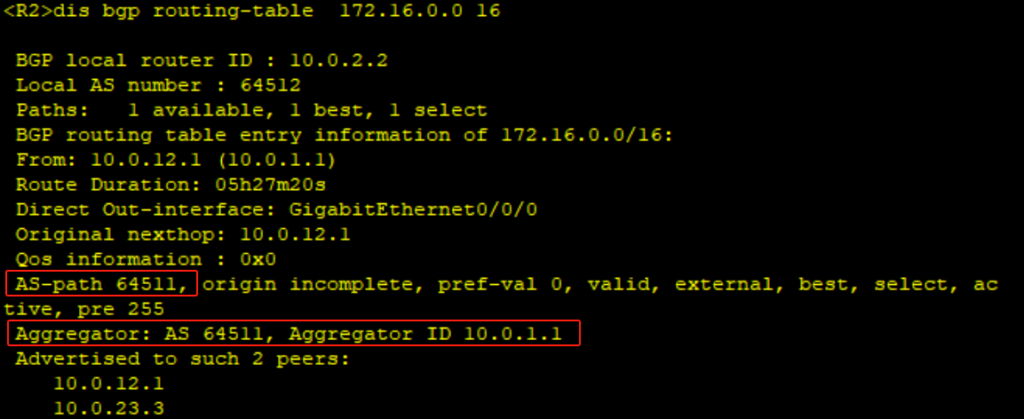
R2上只能看到一条主类路由172.16.0.0/16

该路由的路径属性中存在Aggregator属性,其中携带了汇总路由生成设备所属的AS号以及其RouterID

R3的配置

dis current-configuration | include ip ip-prefix
ip ip-prefix 1 index 10 permit 172.17.0.0 16 greater-equal 24 less-equal 24

dis current-configuration configuration route-policy
[V200R003C00]
#
route-policy hcip permit node 10
if-match ip-prefix 1
#
return

dis current-configuration configuration bgp
[V200R003C00]
#
bgp 64513
peer 10.0.23.2 as-number 64512
#
ipv4-family unicast
undo synchronization
import-route direct route-policy hcip
peer 10.0.23.2 enable
#
return

在R2上对R3引入的路由进行手动汇总。

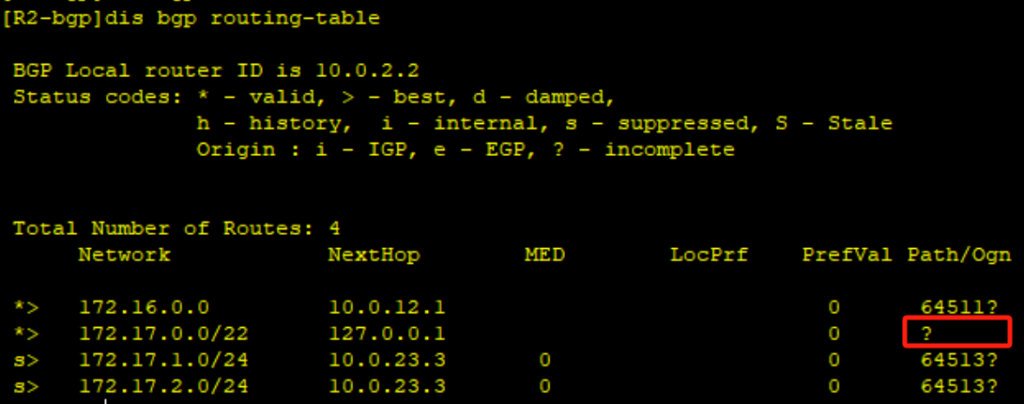
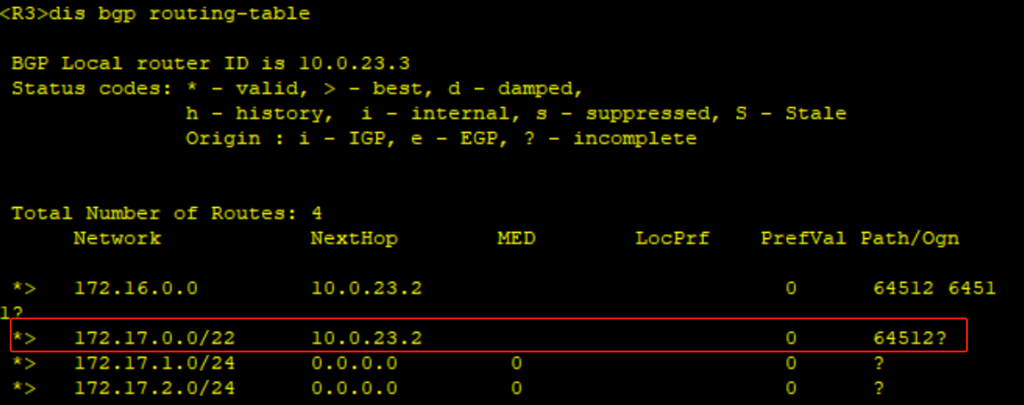
未加as-set 子命令的情况下,R2学习的BGP 路由as-path 为Nil(空),如下图意味着丢失了明细的AS_Path属性值,而BGP 依赖as_path实现防环,因此As_path属性的丢失可能 带来路由的环路。

R3还会学习到172.17.0.0/22的路由形成环路

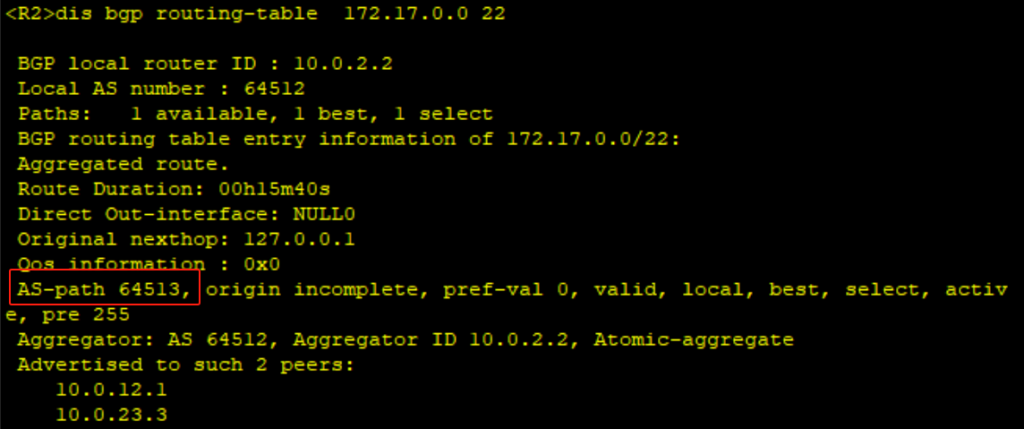
添加as-set (设置as号)

再观察 R2下路由表

路由表中添加了64513

AS-path 添加了

R3收到关于 172.17.0.0/22 的通行之后,在AS_Path 中看到自身的AS号(64513)将会忽略该路由的通告。此时R3的BGP路由表无法看到汇总路由172.17.0.0/22 ,因此通过在手动路由汇总的配置中使用as-set 关键字顺利地规避了路由环路的产生。

Network BGP 基础实验

实验目的

1、配置 AS64512 路由(OSPF) 发布R2、R3、R4中LoopBack0的地址、10.0.23.0/24 10.0.34.0/24 的路由、也就是在哪些接口上激活OSPF。

2、配置AS64513 与AS64512 AS64514与AS64512的静态路由及对等体、配置AS64512 iBGP互连。

3、思考 :指定bgp对等体的源接口为什么需要添加ebpg-max-hop 命令

4、验证各BGP 对等体的建立 、验证IBGP和eBGP路由的下一跳变化。

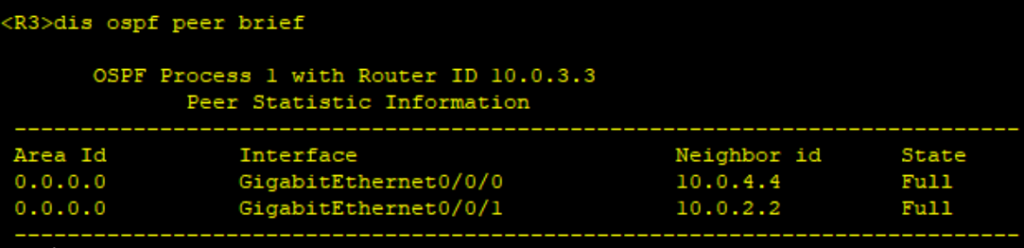
5、查看OSPF邻居的摘要信息

6、在BGP 中发布路由、发布R1、R5环回接口1的路由

7、思考 :在R2、R4 不添加next-hop-local 命令时R3学习的BGP 路由为什么是无效的,为什么在修改R2、R4的下一跳(Next-Hop)后生效

配置各接口及IP

例R3的配置

dis current-configuration interface
[V200R003C00]
#
interface GigabitEthernet0/0/0
ip address 10.0.34.3 255.255.255.0
#
interface GigabitEthernet0/0/1
ip address 10.0.23.3 255.255.255.0
#
interface GigabitEthernet0/0/2
#
interface NULL0
#
interface LoopBack0
ip address 10.0.3.3 255.255.255.255
#
return

配置AS64512 IBGP 全连接

R2、R3、R4使用环回接口LoopBack0作为OSPF Router-ID

以R3配置举例

dis current-configuration configuration ospf
[V200R003C00]
#
ospf 1 router-id 10.0.3.3
area 0.0.0.0
network 10.0.3.3 0.0.0.0
network 10.0.23.3 0.0.0.0
network 10.0.34.3 0.0.0.0
#
return

在R2 R3 R4 基于LoopBack0建立 iBGP 全连接

以R3为例

dis current-configuration configuration bgp
[V200R003C00]
#
bgp 64512
router-id 10.0.3.3
peer 10.0.2.2 as-number 64512
peer 10.0.2.2 connect-interface LoopBack0
peer 10.0.4.4 as-number 64512
peer 10.0.4.4 connect-interface LoopBack0
#
ipv4-family unicast
undo synchronization
peer 10.0.2.2 enable
peer 10.0.4.4 enable
#
return

配置EBGP 对等体

配置R1 R2 之间 R4 R5 之间的LoopBack0路由可达

R1:ip route-static 10.0.2.2 255.255.255.255 10.0.12.2

R2: ip route-static 10.0.1.1 255.255.255.255 10.0.12.1

R4: ip route-static 10.0.5.5 255.255.255.255 10.0.45.5

R5: ip route-static 10.0.4.4 255.255.255.255 10.0.45.4

验证 R1 、R2 之间环回接口可达 ping -c 1 -a 10.0.1.1 10.0.2.2

查看R1的BGP 配置

dis current-configuration configuration bgp
[V200R003C00]
#
bgp 64513
router-id 10.0.1.1
peer 10.0.2.2 as-number 64512
peer 10.0.2.2 ebgp-max-hop 2
peer 10.0.2.2 connect-interface LoopBack0
#
ipv4-family unicast
undo synchronization
network 10.0.1.0 255.255.255.0
network 10.0.1.1 255.255.255.255
network 10.1.1.0 255.255.255.0 //发布路由10.1.1.0
peer 10.0.2.2 enable
#

peer 10.0.2.2 ebgp-max-hop 2 // 手动修改ebgp最大跳数

默认情况eBGP允许的最大跳数为1 、导致EBGP对等体之间只能使用直连链路建立EBGP对等体关系,为使用环回接口作为更新源需要手动修改EBGP连接允许的最大跳数。

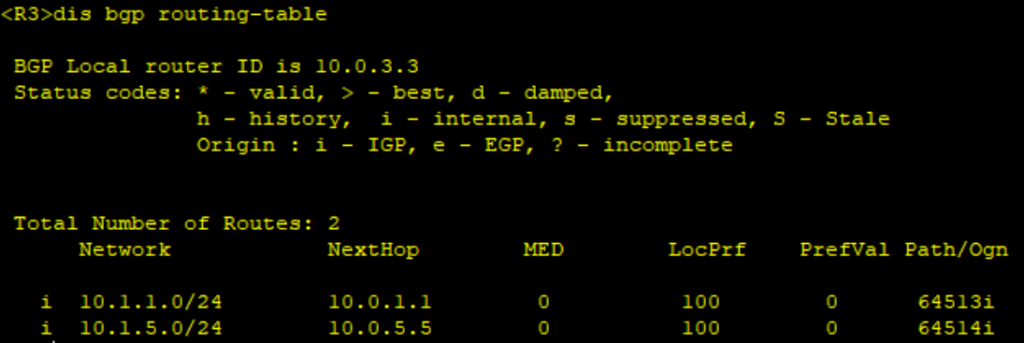
在R3上查看学习的BGP路由

这里R3学习了R1、R5发布的路由 、但是无效的。因为到达 R3到达NextHop是不可达的。

为此需要在R2、R4上修改下一跳指向自己next-hot-local

[R2-bgp]dis this
[V200R003C00]
#
bgp 64512
router-id 10.0.2.2
peer 10.0.1.1 as-number 64513
peer 10.0.1.1 ebgp-max-hop 2
peer 10.0.1.1 connect-interface LoopBack0
peer 10.0.3.3 as-number 64512
peer 10.0.3.3 connect-interface LoopBack0
peer 10.0.4.4 as-number 64512
peer 10.0.4.4 connect-interface LoopBack0
#
ipv4-family unicast
undo synchronization
peer 10.0.1.1 enable
peer 10.0.3.3 enable
peer 10.0.3.3 next-hop-local
peer 10.0.4.4 enable
peer 10.0.4.4 next-hop-local
#
return

[R4-bgp]dis this
[V200R003C00]
#
bgp 64512
router-id 10.0.4.4
peer 10.0.2.2 as-number 64512
peer 10.0.2.2 connect-interface LoopBack0
peer 10.0.3.3 as-number 64512
peer 10.0.3.3 connect-interface LoopBack0
peer 10.0.5.5 as-number 64514
peer 10.0.5.5 ebgp-max-hop 2
peer 10.0.5.5 connect-interface LoopBack0
#
ipv4-family unicast
undo synchronization
peer 10.0.2.2 enable
peer 10.0.2.2 next-hop-local
peer 10.0.3.3 enable
peer 10.0.3.3 next-hop-local
peer 10.0.5.5 enable
#
return

查看R3学习的路由

64513i 这里i 是指通过network 发布的路由,*为有效路由,> 为最优路由

主要查看邻居的状态是否为“Full”

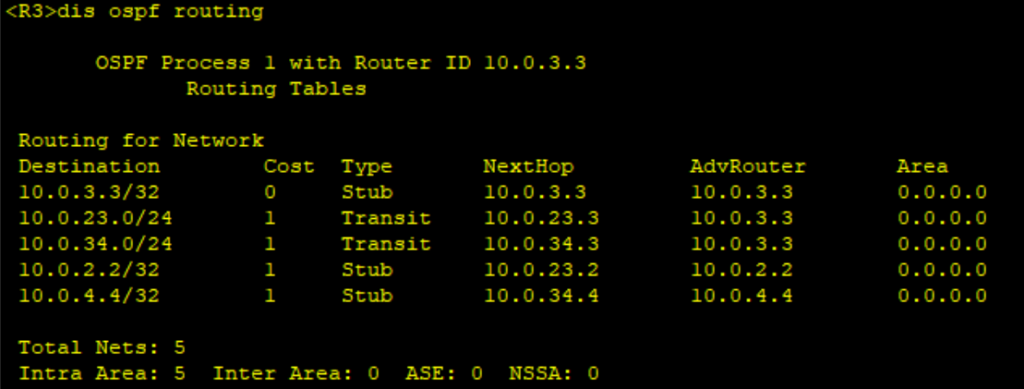
主要查看ospf 学习路由的网络类型“Type”

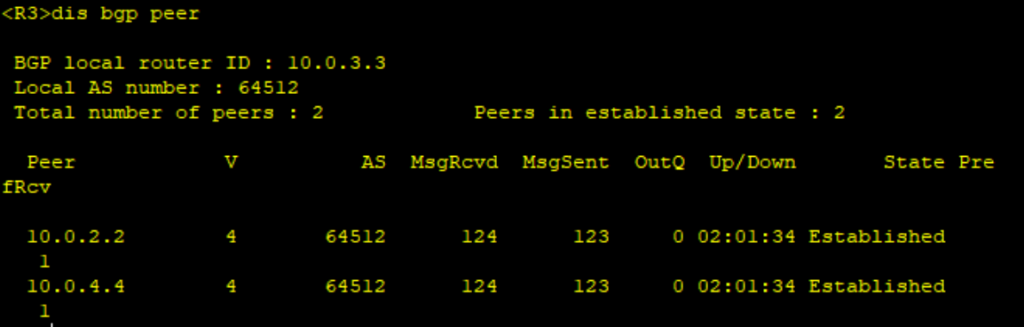
查看iBGP 对等体,主要关注State状态

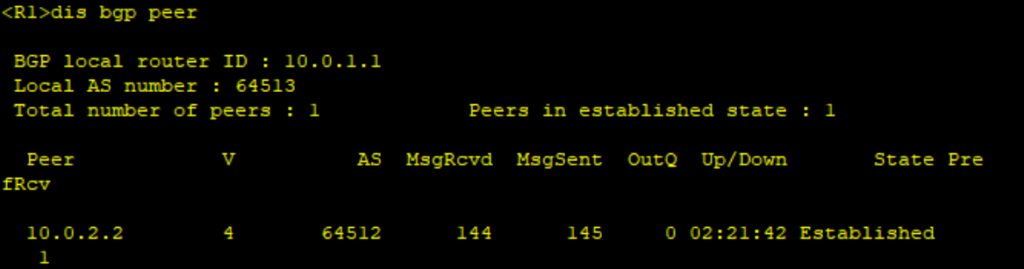
查看EBGP建立的对等体。

测试BGP 发布的路由

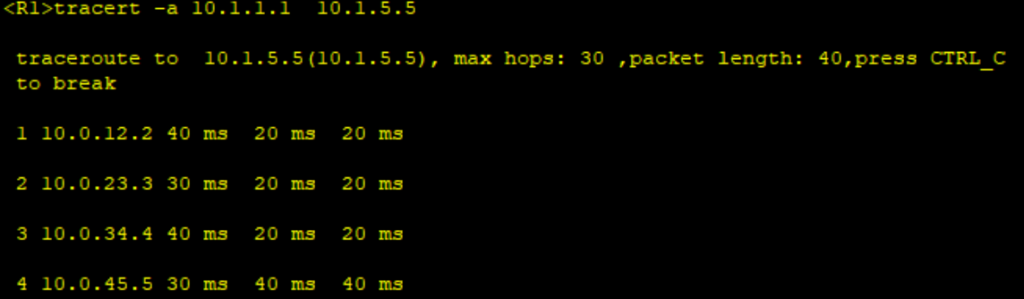
在R1 上使用ping -c 1 -a 10.1.1.1 10.1.5.5

思考 :相较于物理接口建立 EBGP,使用环回接口建立EBGP 对等体的好处。

Loopback接口属于逻辑接口,与物理接口相比,不受链路影响,减少BGP振荡。

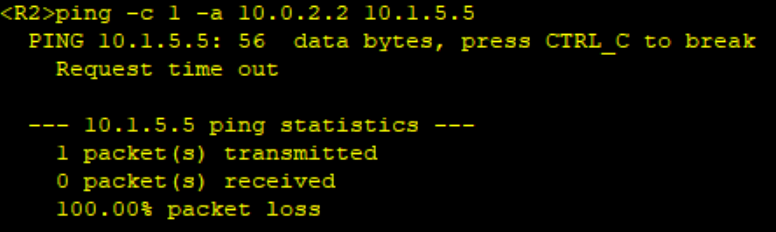
思考 :为什么R1能够Ping 10.1.5.5的路由 R2,R3不能?

因为R2、R3没有到达 R1 10.0.45.0/24 的路由,反之R3、R4也不能到达 10.1.1.1

Network MPLS LDP 基本功能实验

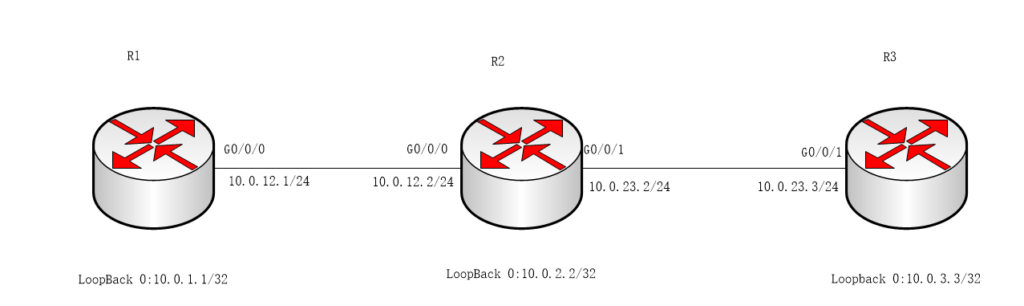
实验拓扑

R1配置

1、各接口及环回接口IP配置

2、配置IGP (OSPF)发布各节点接口所连网段和LSR ID的主机路由

3、在各LSR上使能全局的MPLS和MPLS LDP能力

4、在各LSR的接口上使能MPLS和MPLS LDP能力

5、验证配置结果

R1配置

sysname R1

mpls lsr-id 10.0.1.1 // LSR ID用来在网络中唯一标识一个LSR
mpls //开启全局MPLS

mpls ldp //开启全局MPLS LDP

ospf 1 router-id 10.0.1.1
area 0.0.0.0
network 10.0.1.1 0.0.0.0
network 10.0.12.0 0.0.0.255

interface GigabitEthernet0/0/0
ip address 10.0.12.1 255.255.255.0
mpls
mpls ldp

interface LoopBack0
ip address 10.0.1.1 255.255.255.255

R2 配置

sysname R2

mpls lsr-id 10.0.2.2
mpls

mpls ldp

ospf 1 router-id 10.0.2.2
area 0.0.0.0
network 10.0.2.2 0.0.0.0
network 10.0.12.0 0.0.0.255
network 10.0.23.0 0.0.0.255

interface GigabitEthernet0/0/0
ip address 10.0.12.2 255.255.255.0
mpls
mpls ldp

interface GigabitEthernet0/0/1
ip address 10.0.23.2 255.255.255.0
mpls
mpls ldp

interface LoopBack0
ip address 10.0.2.2 255.255.255.255

R3配置

sysname R3

mpls lsr-id 10.0.3.3
mpls

mpls ldp

ospf 1 router-id 10.0.3.3
area 0.0.0.0
network 10.0.3.3 0.0.0.0
network 10.0.23.0 0.0.0.255

interface GigabitEthernet0/0/1
ip address 10.0.23.3 255.255.255.0
mpls
mpls ldp

interface LoopBack0
ip address 10.0.3.3 255.255.255.255

验证

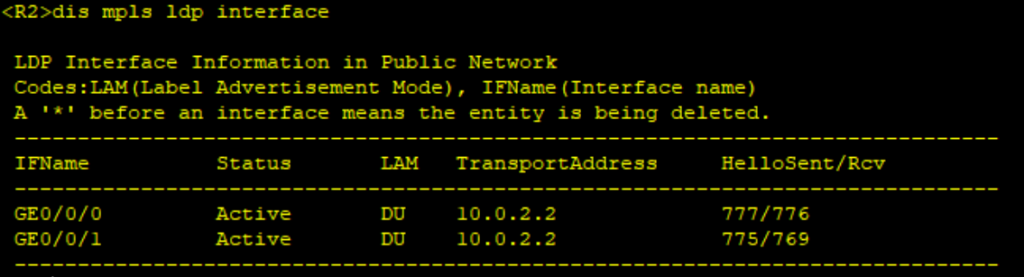
查看启用了LDP 的接口

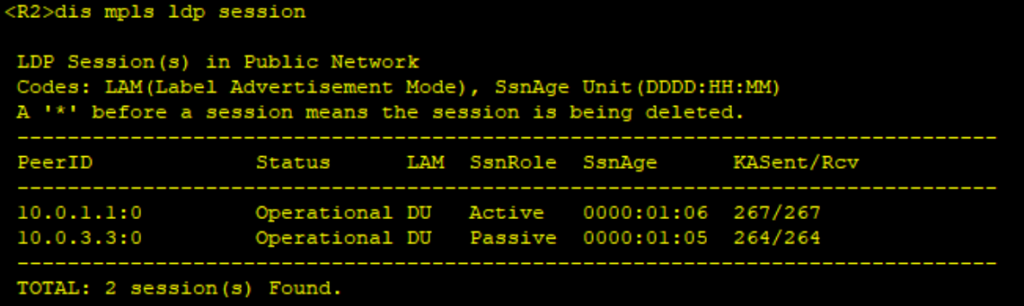
查看LDP 会话 会话状态为Operational 表示会话成功建立。

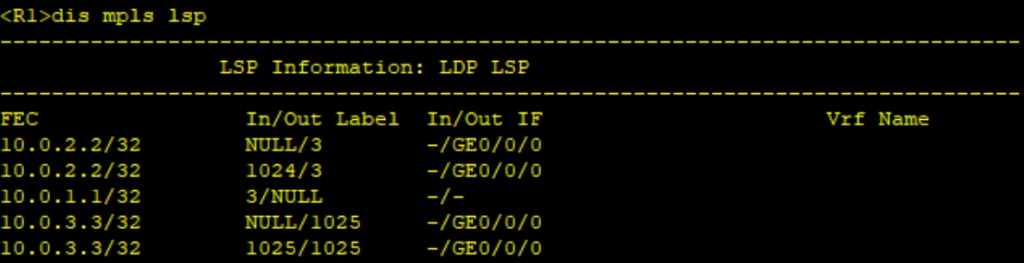
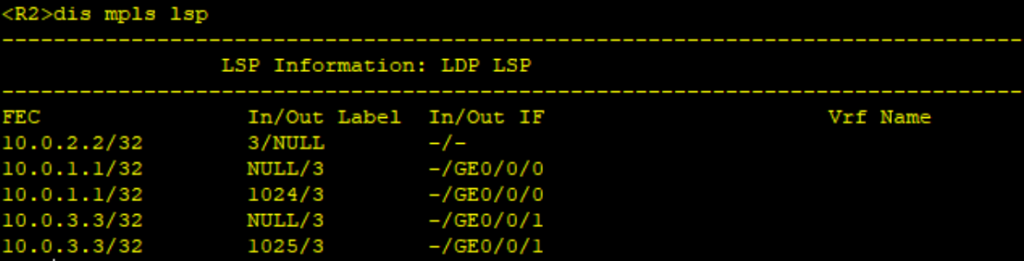
查看MPLS LSP 通道

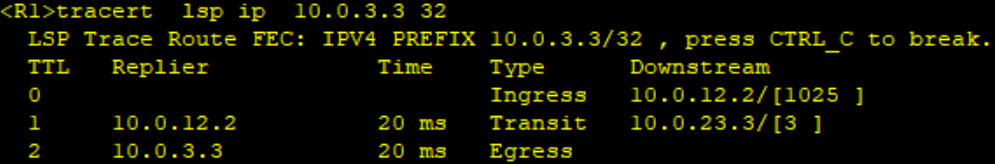
查看R1去往10.0.3.3的MPLS 报文

可以看到R1 出发被打标签是1025 、到达 R2时被替换为3(PHP特殊标签)

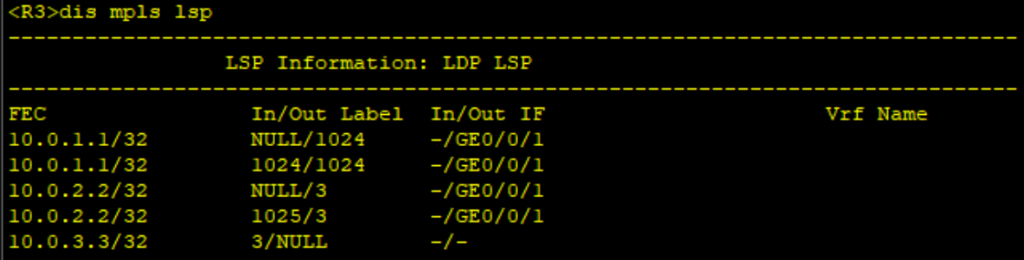
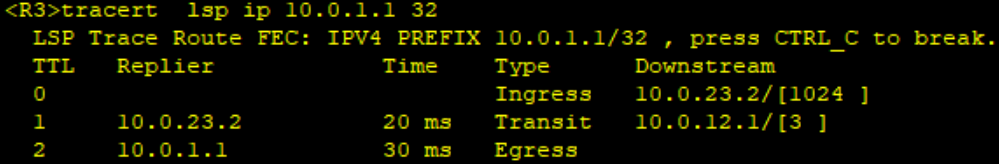
查看R3去往10.0.1.1的MPLS报文

可以看出R3 出发被赋予标签1024、到达R2时被替换为3

思考 为什么标签转发比IP转发的效率更高?

转发知乎

路由器对IP包的转发使用的CPU处理,那么CPU处理每一个IP包就会使用最长掩码匹配原则,举个栗子,如果路由器收到了一个目的IP为192.168.1.1的数据包,此时在路由表中有192.168.0.0/16,192.168.1.0/24,192.168.1.1/32三条路由,那么路由器要经过三次查找,找到最精确的匹配192.168.1.1/32,才能将数据包转发出去。

首先MPLS将路由器的控制层面与转发层面进行了分离。在控制层面中,路由协议生成路由表,标签协议生成标签信息库(LIB)。在标签信息库中会为每一类路由条目分配一个标签,例如前例,对192.168.0.0/16,192.168.1.0/24,192.168.1.1/32三条路由只需要分配一个标签,例如标签20,这就叫转发等价类(FEC),而所有的FEC就构成了路由器的转发平面,我们叫做标签转发表(LIB)。这时路由器来说,原来是收到目的IP是192.168.1.1的数据包,要进行三次查路由表再转发;而现在是收到标签为20的标签包,所以路由器不会查路由表,而是一次查找标签转发表(LIB),找到其他路由器为192.168.0.0分配的标签,直接交换出去。加快了路由器的转发效率。

MPLS 的意义:

意义在于在于标签的加入将IP包这种无连接的转发方式变成了面向连接的转发方式,就是标签转发路径(LSP)的形成。那么一旦面向连接的转发形成以后,我们可以很方便的将MPLS扩展出多种应用,例如VPN,TE,VPLS,等等技术。

Network MPLS LDP配置任务概览

配置MPLS LDP 基本功能

前置任务

在配置MPLS LDP基本功能之前,需完成以下任务:

  • 配置静态路由或IGP协议,使各节点间的IP路由可达

一、配置LSR ID

背景信息

LSR ID用来在网络中唯一标识一个LSR。LSR没有缺省的LSR ID,必须手工配置。为了提高网络的可靠性,推荐使用LSR某个Loopback接口的地址作为LSR ID。

请在MPLS域的所有节点上进行以下配置。

  1. 执行命令mpls lsr-id lsr-id,配置本节点的LSR ID。缺省情况下,没有配置LSR ID。
  2. 如果要修改已经配置的LSR ID,必须先在系统视图下执行undo mpls命令。undo mpls 会删除MPLS 的所有配置,所以要事先规划好lsr ID.

二、开启MPLS 全局功能

执行命令mpls,使能全局MPLS功能,并进入MPLS视图

二、开启MPLS LDP 全局功能

执行命令mpls ldp,使能全局的LDP功能,并进入MPLS-LDP视图。

(可选)执行命令lsr-idlsr-id,配置LDP实例的LSR ID。

缺省情况下,LDP实例的LSR ID等于节点的LSR ID。推荐采用缺省值。

在某些使用VPN实例的组网方案中(例如BGP/MPLS IP VPN),如果VPN私网地址与LSR ID重叠,则需要为LDP另外配置LSR ID,以保证TCP连接能够正常建立。

三、配置LDP 会话

分为 本地LDP 会话和远端LDP 会话

本地LDP 会话通常是直连相信的LSR 之间,远端LDP会话是不相邻的LSR建立。

  • 配置本地LDP会话请在两台相邻的LSR上进行以下配置。
    1. 执行命令system-view,进入系统视图。
    2. 执行命令interface interface-type interface-number,进入需要建立LDP会话的接口视图。
    3. 执行命令mpls,使能接口的MPLS能力。缺省情况下,接口的MPLS能力处于未使能状态。
    4. 执行命令mpls ldp,使能接口的MPLS LDP能力。缺省情况下,接口的MPLS LDP能力处于未使能状态。
  • 配置远端LDP会话请在远端LDP会话两端的LSR上进行以下配置。
    1. 执行命令system-view,进入系统视图。
    2. 执行命令mpls ldp remote-peer remote-peer-name,创建MPLS LDP远端对等体,并进入MPLS LDP远端对等体视图。
    3. 执行命令remote-ip ip-address,配置MPLS LDP远端对等体的IP地址。缺省情况下,没有配置LDP远端对等体的IP地址。配置的远端对等体的IP地址必须是远端对等体的LSR ID。LDP实例的LSR ID和节点的LSR ID不一致时,要使用LDP实例的LSR ID